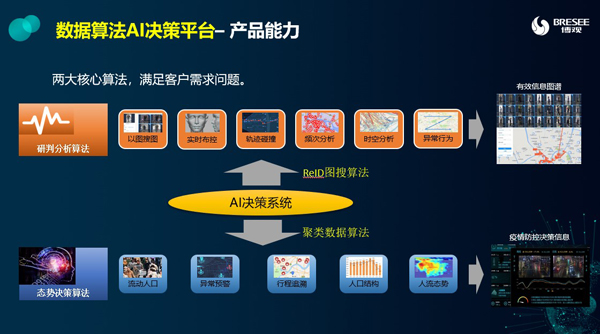
数据采集是人工智能领域中的基础环节,它涉及从各种来源收集原始数据的过程。数据采集的目的是为了获取能够用于训练模型、分析趋势或进行其他数据处理任务的原始信息。数据采集涵盖了从数据收集、存储到预处理的一系列步骤,是保证数据质量和模型功能的关键。
(1)主动采集:通过编程或自动化工具直接从数据源获取数据,如Web爬虫从互联网上抓取信息。
(1)Web爬虫工具:如BeautifulSoup、Scrapy等,用于从网页中提取结构化数据。
(3)数据采集软件:如DataRobotics、Talend等,提供集成化的数据采集解决方案。
(5)数据采集框架:如ApacheNutch、Elasticsearch等,用于构建高效的数据采集系统。
数据清洗是数据预处理阶段的关键步骤,旨在去除或修正数据集中的错误、异常和重复信息。数据清洗包括以下几方面:
(2)异常值处理:识别并处理数据集中的异常值,如超出合理范围的数值、异常分布等。
(3)重复数据处理:识别并删除数据集中的重复记录,保证数据的一致性和准确性。
(4)格式化处理:统一数据格式,如日期、时间、货币等,便于后续处理和分析。
数据转换是指将原始数据转换为适合分析和建模的格式。以下是一些常见的数据转换方法:
(4)编码处理:将类别型数据转换为数值型数据,如使用独热编码或标签编码。
数据集成是指将来自不同来源、格式和结构的数据合并为一个统一的数据集。数据集成主要包括以下步骤:
(4)数据一致性处理:保证集成后的数据具有一致性,如时间戳统一、单位统一等。
数据库技术是数据存储的核心,它涉及数据的组织、管理和检索。在领域,数据库技术主要用于存储和管理大规模数据集,以下是一些常见的数据库技术:
(1)关系型数据库:以表格形式存储数据,通过SQL(结构化查询语言)进行数据操作。如MySQL、Oracle、SQLServer等。
(2)非关系型数据库:不遵循传统的表格结构,以文档、键值对、图形等形式存储数据。如MongoDB、Cassandra、Redis等。
(3)分布式数据库:通过分布式架构实现数据的横向扩展,提高数据存储和处理能力。如HBase、AmazonDynamoDB等。
数据量的不断增长,传统的集中式存储系统已无法满足需求。分布式存储系统通过将数据分散存储在多个节点上,提高了数据可用性、可靠性和扩展性。以下是一些常见的分布式存储系统:
(1)HadoopHDFS:基于Hadoop框架的分布式文件系统,适用于大规模数据存储和处理。
(2)Ceph:一个开源的分布式存储系统,支持块存储、文件存储和对象存储。
(3)GlusterFS:一个开源的分布式文件系统,支持网络存储和横向扩展。
数据仓库技术用于将来自不同数据源的数据进行整合、清洗、转换和存储,为数据分析提供支持。以下是一些常见的数据仓库技术:
(1)SQL数据仓库:基于关系型数据库构建的数据仓库,如Teradata、OracleExadata等。
数据挖掘,又称知识发觉,是信息科学领域中的一项关键技术。它涉及从大量、复杂、不一致的数据集中提取有价值的信息、模式和知识的过程。数据挖掘的目标是通过应用统计方法、机器学习算法和数据库技术,从数据中发觉隐藏的规律和关联,为决策支持提供科学依据。
(1)聚类算法:通过将相似的数据点分组,帮助用户发觉数据中的自然结构。常见的聚类算法有K均值、层次聚类和密度聚类等。
(2)关联规则挖掘算法:用于发觉数据集中项目之间的关联性,常见的算法有Apriori算法和FPgrowth算法。
(3)分类算法:根据数据特征对数据进行分类,常用的分类算法有决策树、支持向量机和神经网络等。
(4)聚类算法:用于发觉数据集中项目之间的关联性,常见的算法有Apriori算法和FPgrowth算法。
(5)回归算法:用于预测数据未来的趋势,常见的回归算法有线性回归、非线性回归和岭回归等。
(6)时序分析算法:针对时间序列数据进行分析,常用的算法有自回归模型、移动平均模型和季节性分解等。
(7)异常检测算法:用于检测数据集中的异常值或异常模式,常见的算法有孤立森林、局部异常因数和K近邻等。
(1)营销领域:通过数据挖掘分析顾客购买行为,帮助企业进行精准营销,提高销售额。
(2)金融领域:在金融风控、反欺诈和信用评估等方面,数据挖掘技术能够帮助金融机构识别风险,降低损失。
(3)医疗领域:数据挖掘技术可应用于疾病诊断、药物研发和患者健康管理等环节,提高医疗质量和效率。
(4)电信领域:通过分析用户行为和通信数据,电信运营商可以优化网络资源,提高服务质量。
(5)物流领域:数据挖掘技术可用于物流路径优化、库存管理和供应链管理等方面,降低成本,提高效率。
(6)互联网领域:在推荐系统、广告投放和搜索引擎等领域,数据挖掘技术能够为用户提供个性化的服务。
特征提取是数据预处理阶段的关键步骤,旨在从原始数据中提取出具有代表性的信息。该过程主要包括以下内容:
(1)数据清洗:对原始数据进行预处理,包括填补缺失值、去除异常值和噪声等,以保证数据质量。
(2)特征选择:从原始数据中筛选出与目标变量相关度较高的特征,减少冗余信息。
(3)特征提取方法:根据数据类型和目标变量的特点,选择合适的特征提取方法,如频域分析、时域分析、统计特征提取等。
(4)特征变换:对提取出的特征进行变换,如归一化、标准化等,以提高后续处理的效果。
(5)特征融合:将不同方法提取的特征进行融合,以获得更全面、准确的特征表示。
特征选择是特征工程中的一个重要环节,旨在从众多特征中挑选出对模型功能有显著影响的特征。主要方法包括:
(1)统计方法:根据特征与目标变量之间的相关性、方差、条件方差等统计指标进行选择。
(4)支持向量机(SVM)特征选择:利用SVM模型对特征进行排序,选择重要性较高的特征。
特征降维是减少特征维度的过程,旨在降低数据复杂度、提高计算效率。主要方法包括:
(1)主成分分析(PCA):通过线性变换将原始数据投影到低维空间,保留主要信息。
(2)非线性降维方法:如等距映射(Isomap)、局部线性嵌入(LLE)等,将高维数据映射到低维空间。
(3)流形学习方法:如局部线性嵌入(LLE)、拉普拉斯特征映射(LDA)等,基于流形结构进行降维。
(4)特征选择与降维结合:通过特征选择方法筛选出重要特征,然后对重要特征进行降维。
通过以上特征工程技术,可以提高模型的学习效率和预测精度,为后续的数据挖掘和机器学习任务奠定基础。
数据可视化方法是指将数据以图形、图像等形式直观展示的技术。以下是一些常见的数据可视化方法:
2、成为VIP后,下载本文档将扣除1次下载权益。下载后,不支持退款、换文档。如有疑问请联系我们。
3、成为VIP后,您将拥有八大权益,权益包括:VIP文档下载权益、阅读免打扰、文档格式转换、高级专利检索、专属身份标志、高级客服、多端互通、版权登记。
4、VIP文档为合作方或网友上传,每下载1次, 网站将根据用户上传文档的质量评分、类型等,对文档贡献者给予高额补贴、流量扶持。如果你也想贡献VIP文档。上传文档
1.11 有理数的乘方 教学课件 --2026-2027学年华东师大版数学七年级上册.pptx
1.4 绝对值 教学课件 --2026-2027学年华东师大版数学七年级上册.pptx
2026语文新教材 第4课《古代诗歌四首-闻王昌龄左迁龙标遥有此寄》课件.pptx
2026数学新教材 人教版(2024)八年级上册数学 15.1.2线段的垂直平分线张PPT).pptx
2026数学新教材 人教版(2024)七年级上册数学 5.2 解一元一次方程 课件(共21张PPT).pptx
2026数学新教材 人教版(2024)七年级上册数学 2.2.1 有理数的乘法(共22张PPT).pptx
2026语文新教材 10 美丽的颜色 课件(共37张PPT).pptx
2026数学 3.4 日历中的数量关系课件(共21张PPT) 北师大版(新教材)六年级上册数学.pptx
(高清版)B-T 42588-2023 系统与软件工程功能规模测量NESMA方法.pdf
原创力文档创建于2008年,本站为文档C2C交易模式,即用户上传的文档直接分享给其他用户(可下载、阅读),本站只是中间服务平台,本站所有文档下载所得的收益归上传人所有。原创力文档是网络服务平台方,若您的权利被侵害,请发链接和相关诉求至 电线) ,上传者